1 · Suivi et ré-identification
Détecter chaque personne, la suivre d'une image à l'autre et lui garder la même identité tout au long de la séquence.
Projet de M1 · Vision par ordinateur
La reconnaissance faciale suppose que la personne coopère : visage dégagé, regard vers la caméra, démarche normale. Ce projet de M1, mené à deux pendant trois mois à l'ISEN Nantes, mesure automatiquement ce degré de coopération à partir d'une simple vidéo.
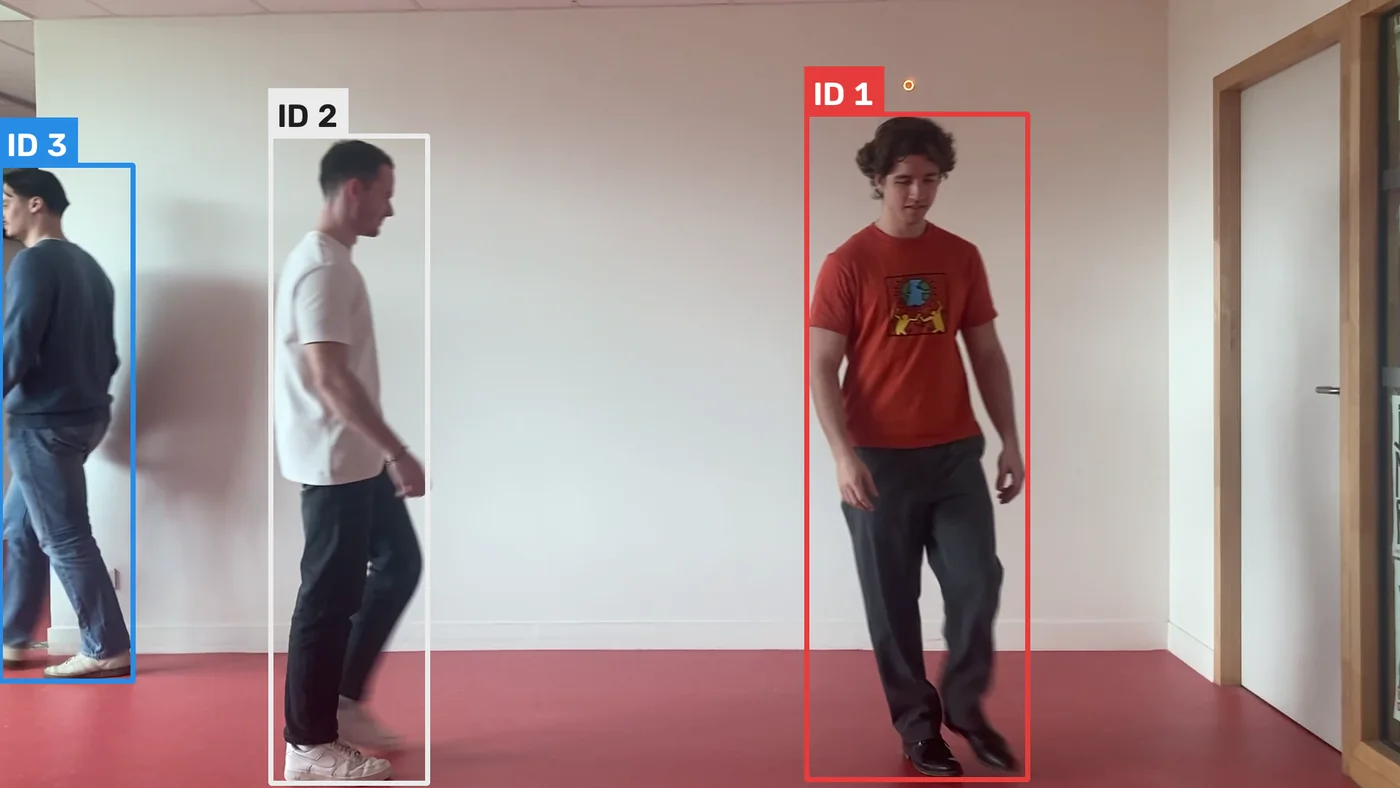
En conditions contrôlées, les systèmes de reconnaissance faciale dépassent 99 % de bonnes vérifications. Dans un couloir de contrôle d'accès ou un espace public, leurs performances chutent dès que la personne ne coopère pas : regard détourné, visage masqué, tête inclinée, passage en courant.
Évaluer automatiquement, en temps réel et sans gêner la personne, son degré de coopération. Il ne s'agit pas de remplacer la reconnaissance faciale, mais de lui fournir une analyse de contexte :
Projet de M1 de l'ISEN Nantes, d'une durée de trois mois, réalisé en binôme : nous avons travaillé ensemble sur l'ensemble des tâches. Il était encadré par Khadidja Ould Amer et Cyril Barrelet.
Une méthode agile en cinq sprints, chacun livrant une fonctionnalité testable seule : état de l'art et architecture, modules visage et regard, analyse de la démarche, modules complémentaires, optimisation et finalisation. Le code vivait sur un dépôt GitHub privé, avec une branche par module.
Fonctionner sur un processeur standard, sans carte graphique dédiée, accepter une vidéo ou une webcam en entrée, et ne conserver aucune donnée biométrique par défaut.
Quatre blocs indépendants, chacun exécutable seul, écrits en Python.
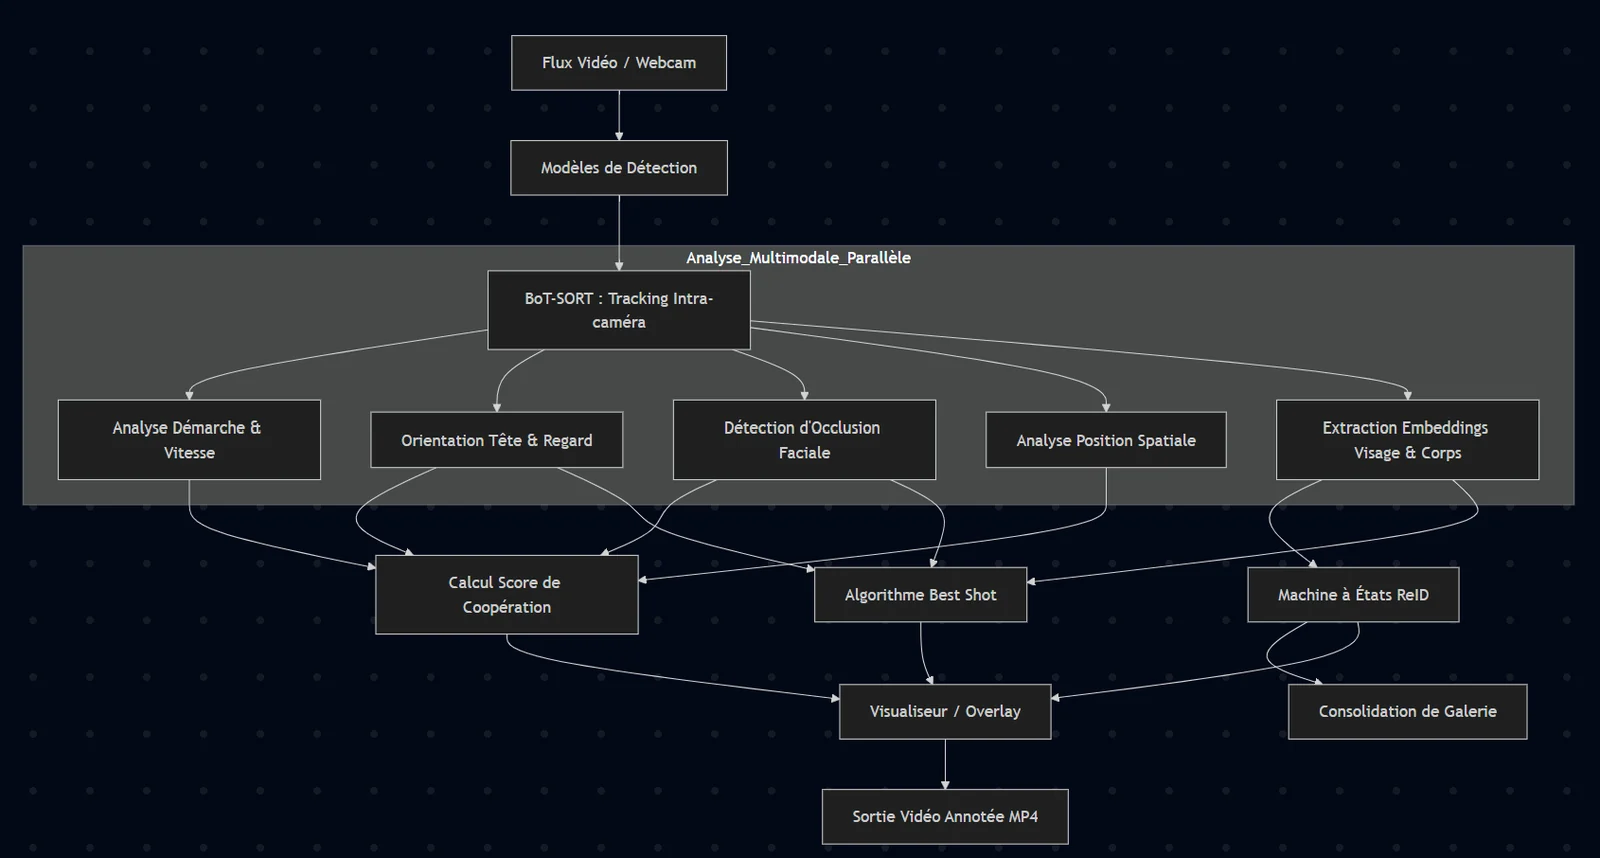
Détecter chaque personne, la suivre d'une image à l'autre et lui garder la même identité tout au long de la séquence.
Estimer le squelette, la vitesse de déplacement et repérer course, démarche inhabituelle ou personne au sol.
Mesurer, zone par zone, ce qui cache le visage : main, masque, objet.
Estimer l'orientation de la tête, la direction du regard et l'ouverture des yeux pour décider si la personne coopère.
Le bloc central : sans identité stable, aucune mesure ne peut être suivie dans le temps.
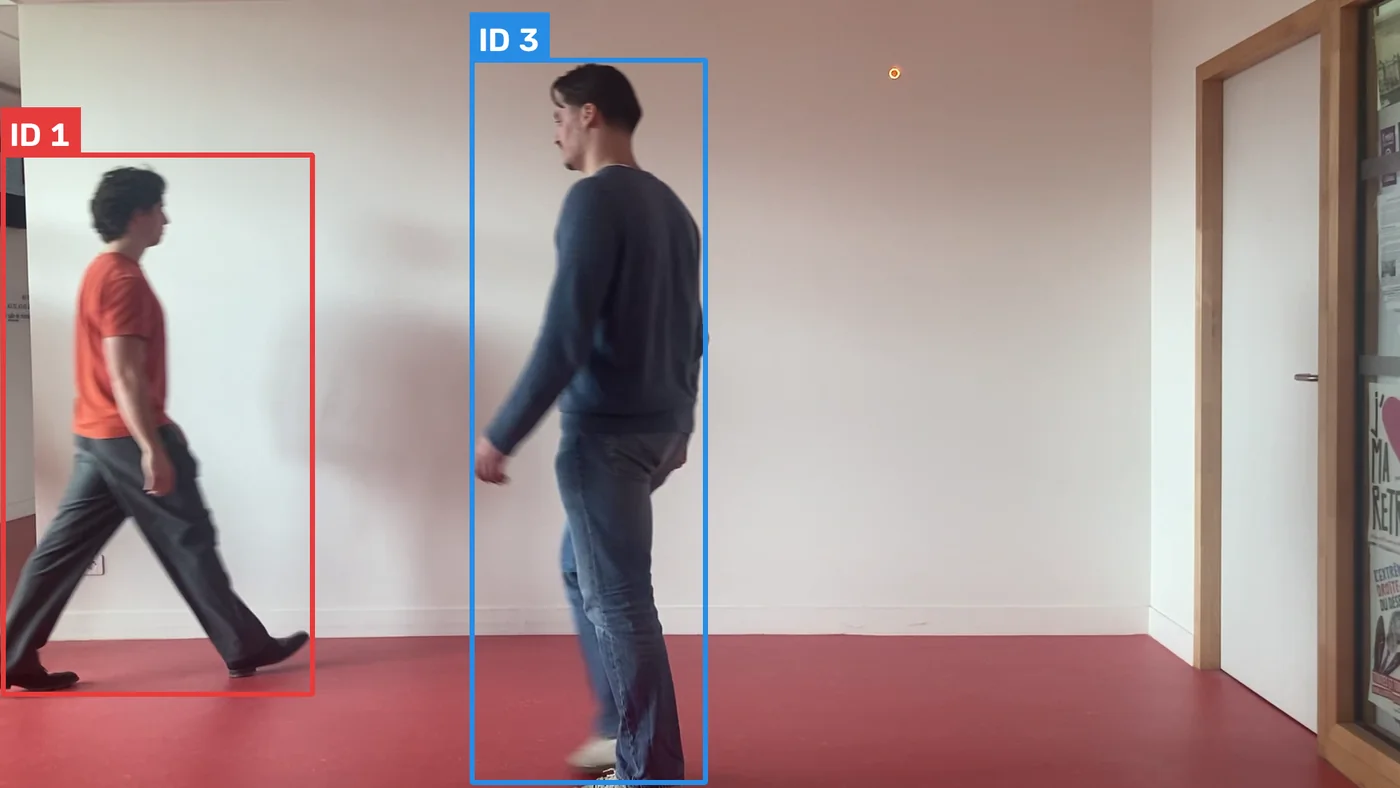
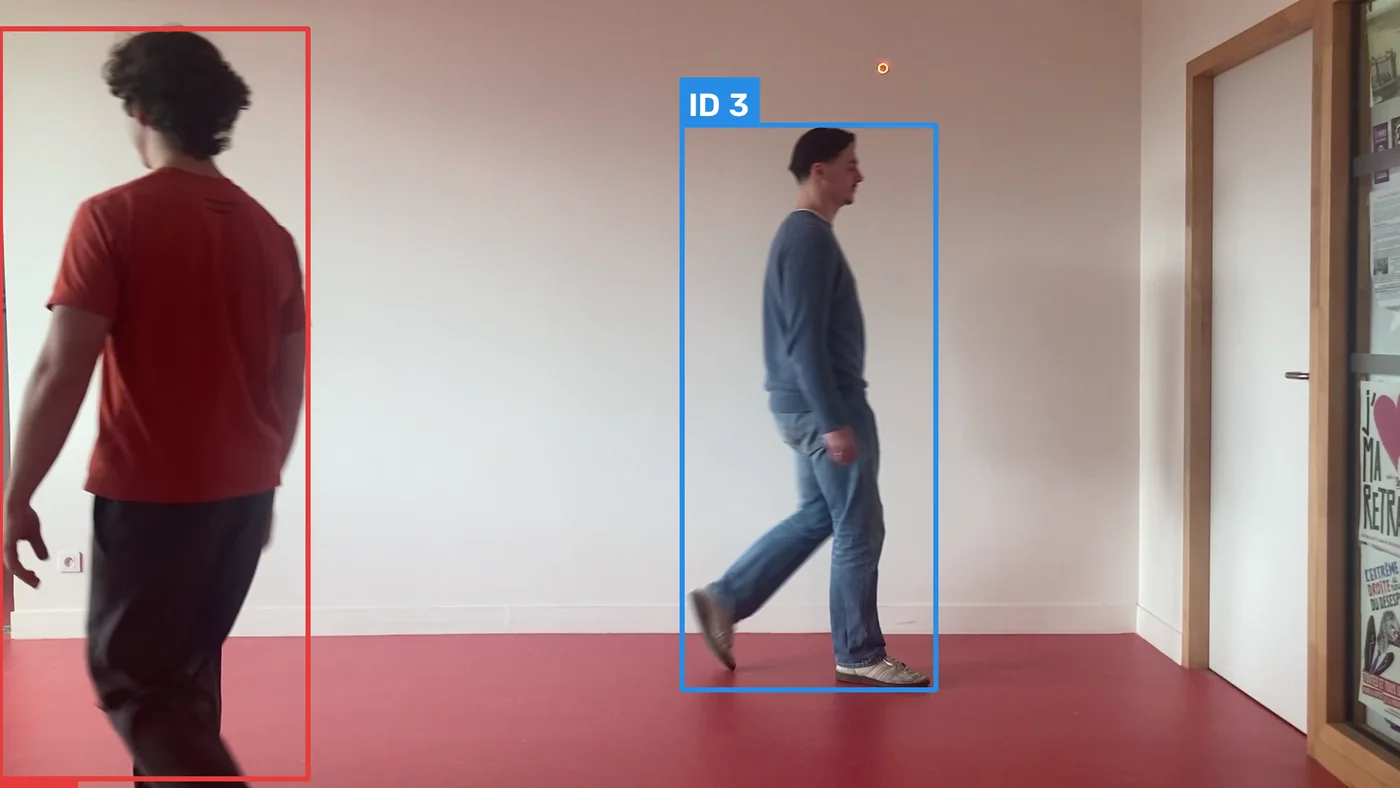
YOLOv8m-seg détecte les personnes et fournit le masque de chacune ; BoT-SORT les suit d'une image à l'autre. Le seuil de confiance est abaissé à 0,30 pour ne pas perdre les personnes de profil ou à moitié visibles.
InsightFace fournit une empreinte du visage, retenue seulement si le visage est assez grand, bien détecté et géométriquement plausible, ce qui écarte les arrières de tête. Une empreinte du corps est calculée sur le masque de la personne. Les deux sont fusionnées, le corps pesant un peu plus : les vêtements distinguent bien deux à cinq personnes filmées ensemble.
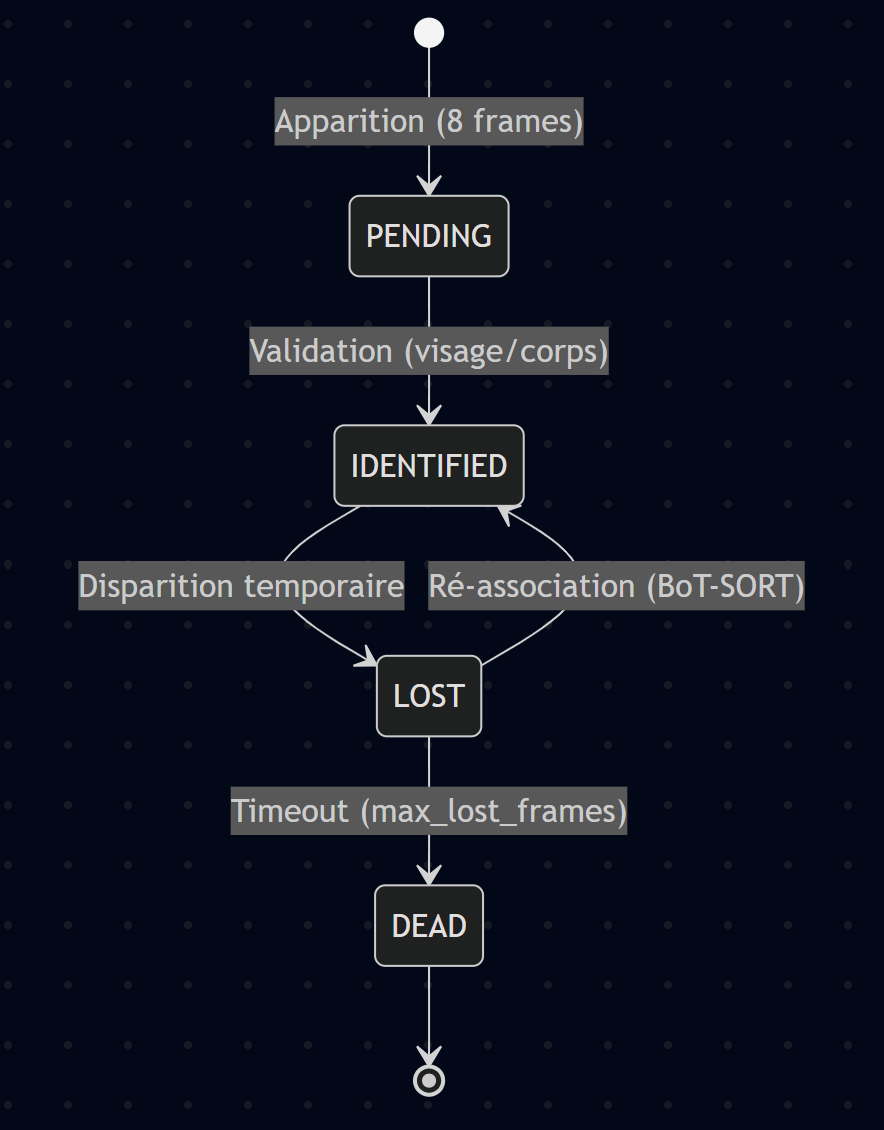
Une machine à états attend huit images avant d'attribuer une identité, conserve les pistes perdues pour les ré-associer, et durcit ses seuils quand deux personnes sont proches. Une galerie garde plusieurs prototypes par personne, et une consolidation régulière fusionne les identités créées en double.
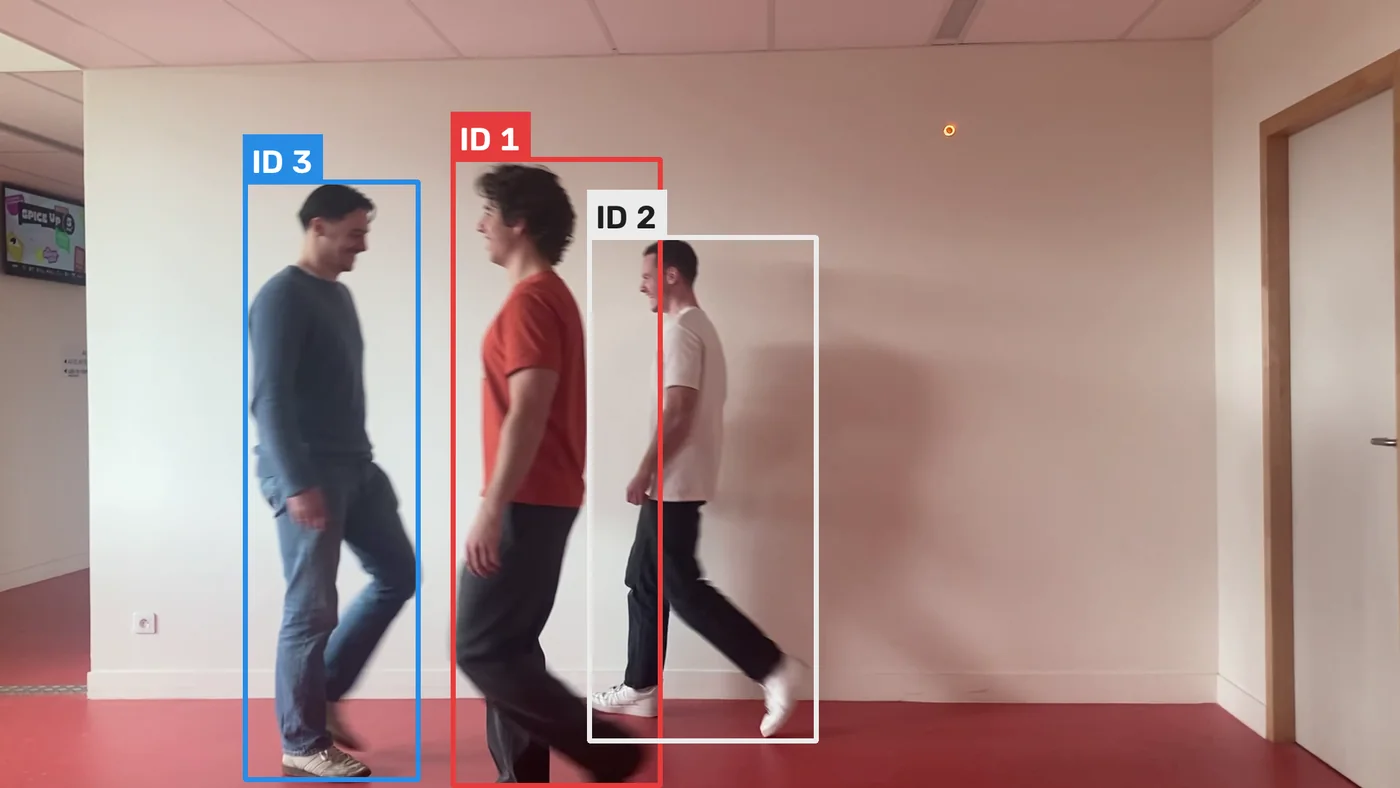
Pour les vidéos traitées après coup, une seconde chaîne mesure la couleur du torse sur le masque de chaque personne, retrouve les couleurs de référence par K-means, puis attribue les identités image par image avec l'algorithme hongrois. Un fichier de diagnostic signale les passages ambigus, qu'un fichier de corrections permet de trancher.
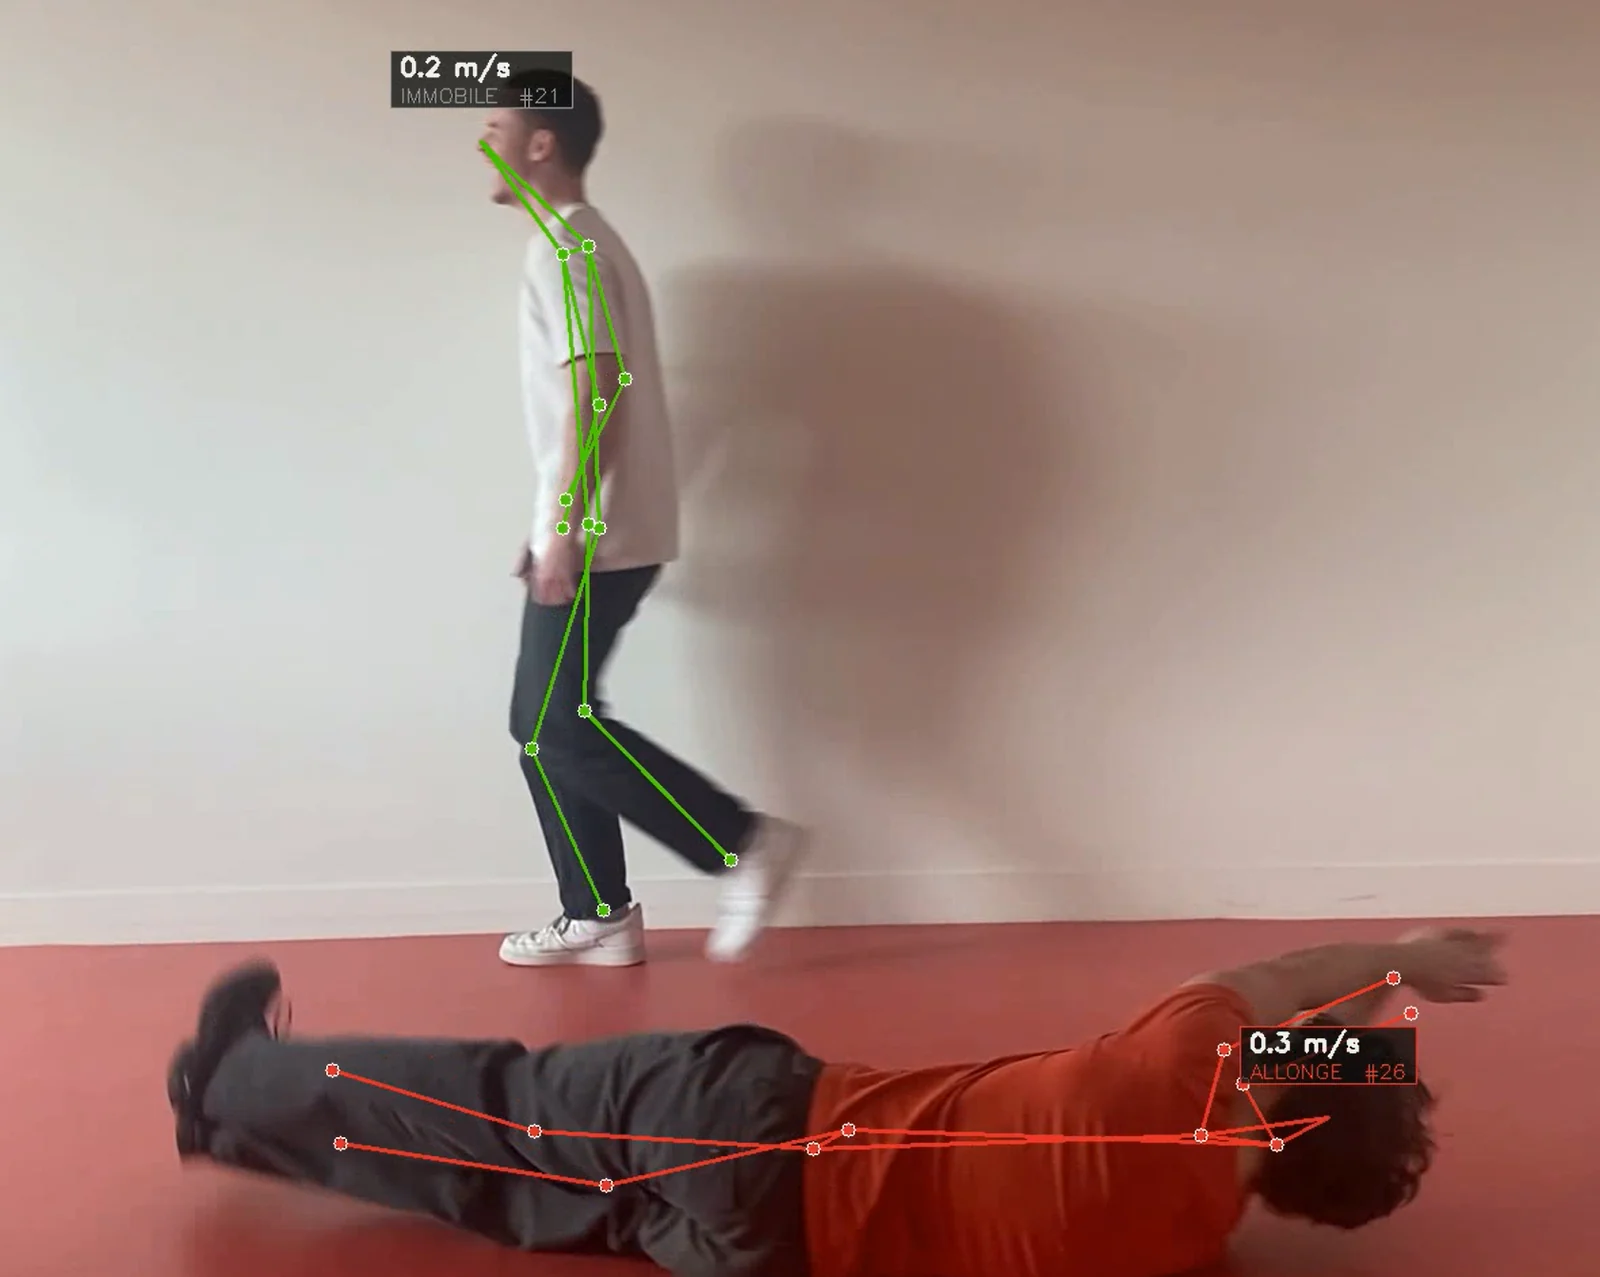
YOLOv8-pose estime les 17 points clés du squelette de chaque personne. La vitesse est calculée à partir du déplacement du centre des hanches ; l'échelle en mètres est déduite de la taille du squelette, rapportée à une taille moyenne de 1,70 m, puis la mesure est lissée.
Un vote majoritaire sur dix images évite que la classe ne change à chaque instant. Le module a été testé sur le jeu public Penn Action et sur nos propres vidéos.
Deux blocs qui partagent les mêmes points de repère du visage.
MediaPipe FaceMesh place 478 points de repère sur le visage, qui délimitent des zones anatomiques : yeux, nez, bouche, joues, front. La couleur de peau de la personne est étalonnée sur les premières images, dans l'espace Y'CbCr qui sépare la luminosité de la couleur. Une zone où trop peu de pixels ressemblent à de la peau est considérée comme masquée.
Le score global, de 0 à 100, pondère les zones selon leur importance pour la reconnaissance : les yeux et le nez comptent trois fois plus que le front. Il a été testé avec une main devant le visage, un masque médical, un objet tenu devant soi et des éclairages variés.
L'orientation de la tête est estimée par résolution PnP à partir de six points du visage : nez, menton, coins des yeux et commissures des lèvres. L'ouverture des yeux est mesurée par le rapport d'aspect de l'œil, et la direction du regard par la position de l'iris.
La personne est jugée coopérative si ses deux yeux sont ouverts, si son regard vise la caméra et si sa tête n'est pas tournée de plus de 25° sur le côté ni de plus de 20° vers le haut ou le bas. Un vote sur quatorze images stabilise l'affichage.
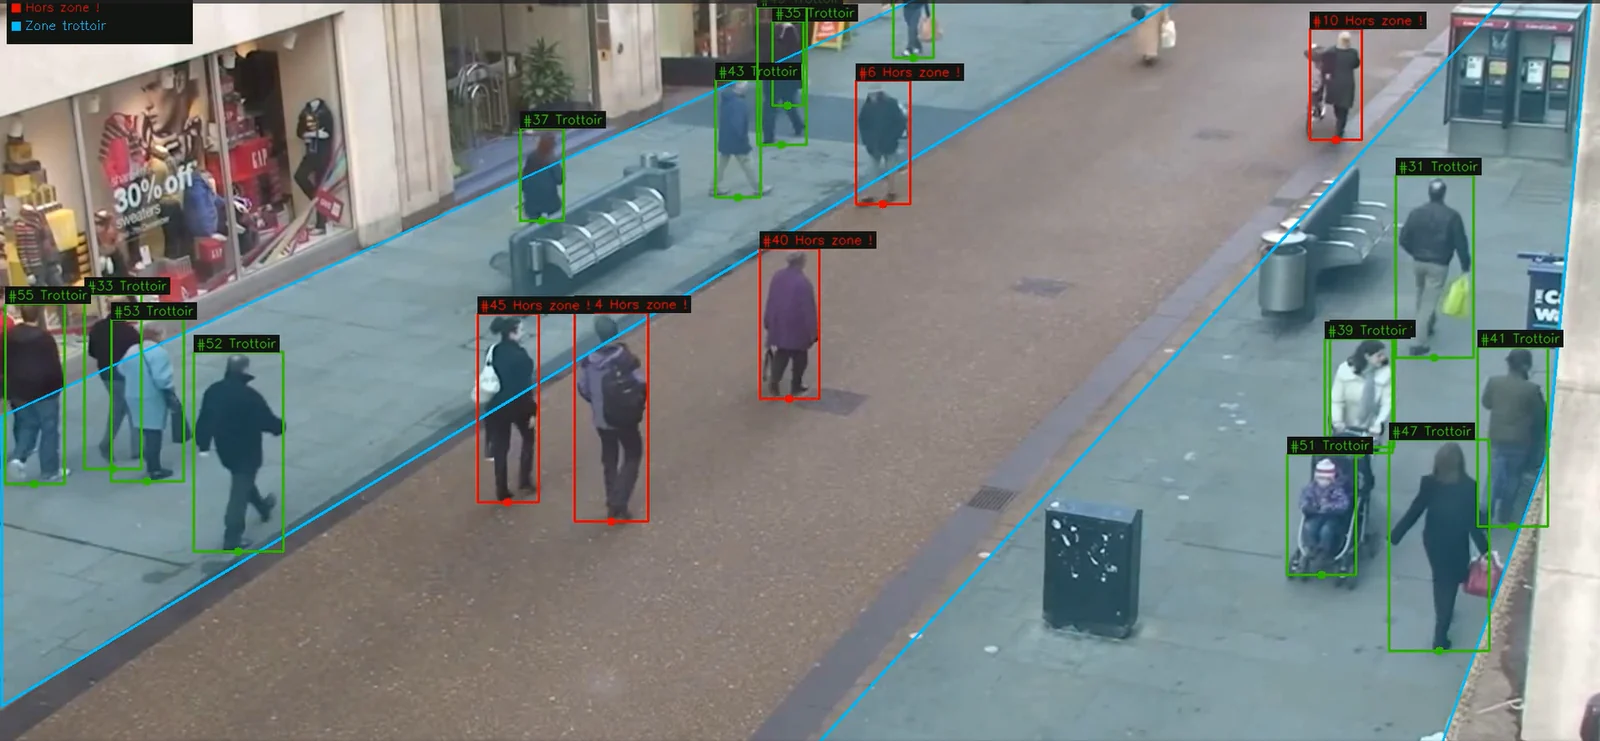
L'utilisateur trace les zones autorisées sur l'image, par exemple un trottoir. Elles sont converties en un masque, et à chaque image le point au sol de chaque personne suivie est testé : une personne qui passe plus de 30 % du temps hors zone est signalée.
Pour chaque identité, l'algorithme retient l'image la plus exploitable de la séquence. Son score combine la qualité du visage, son orientation face à la caméra et l'absence d'occlusion.
Les six tâches du sujet ont été traitées ; les chiffres ci-dessous viennent des tests du rapport de projet.
Détection et segmentation des personnes, estimation du squelette.
Suivi multi-personnes, choisi à la place de DeepSORT pour sa meilleure gestion des occlusions.
Empreintes du visage (ArcFace) pour la ré-identification.
478 points de repère du visage, iris compris.
Lecture vidéo, espaces de couleur, résolution PnP, rendu annoté.
Inférence optimisée sur processeur ; entraînements sur GPU.
Le cahier des charges, la gestion de projet et le détail de chaque bloc.