Big Data · IA · Web
Analyse du trafic maritime à partir de données AIS
Un projet de 3e année en trois volets — Big Data, intelligence artificielle et développement web — autour des données AIS (positions de navires) du golfe du Mexique.
Les trois volets
Chaque volet se parcourt en sept étapes, illustrées par les figures du projet.
Analyse Big Data
-
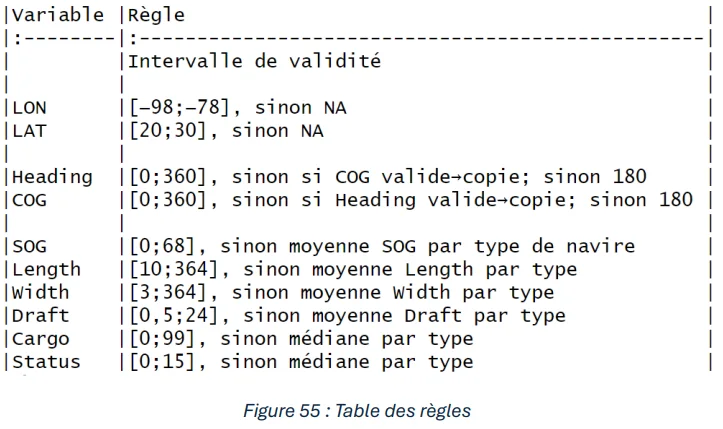
Collecte et nettoyage des données
Acquisition de millions de points de données AIS dans le golfe du Mexique. Traitement des valeurs manquantes et aberrantes, puis suppression des doublons pour garantir la qualité de l'analyse.
-
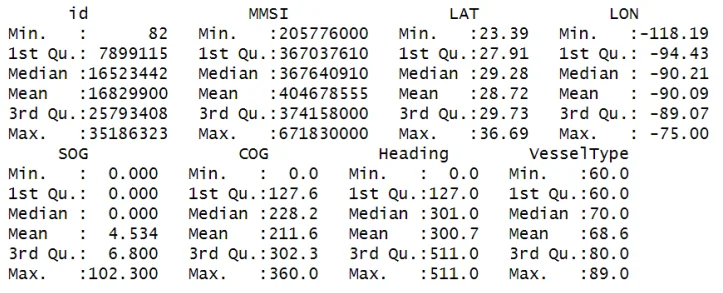
Statistiques descriptives
Analyse univariée des variables : latitude, longitude, vitesse (SOG), cap (COG). Identification des schémas de navigation et des zones de forte densité maritime.
-
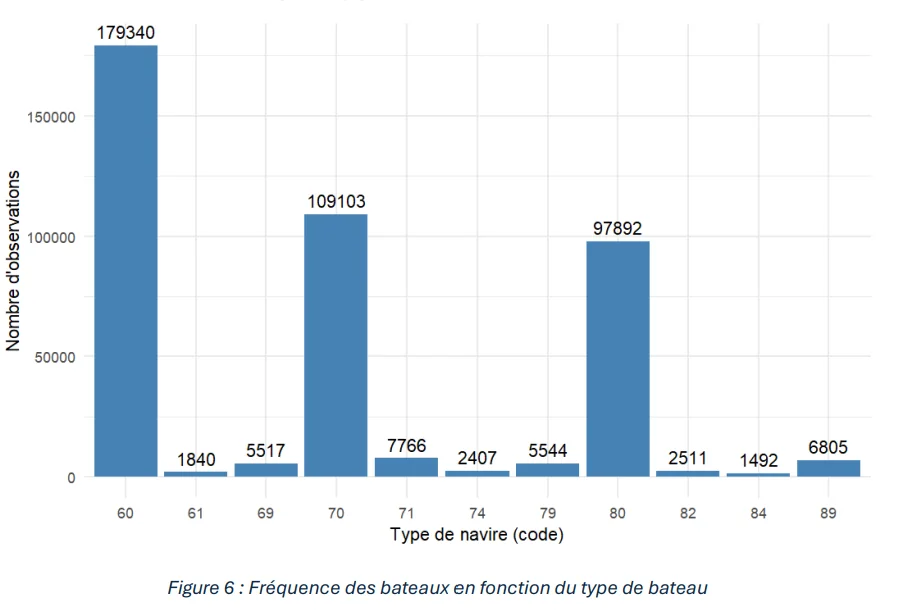
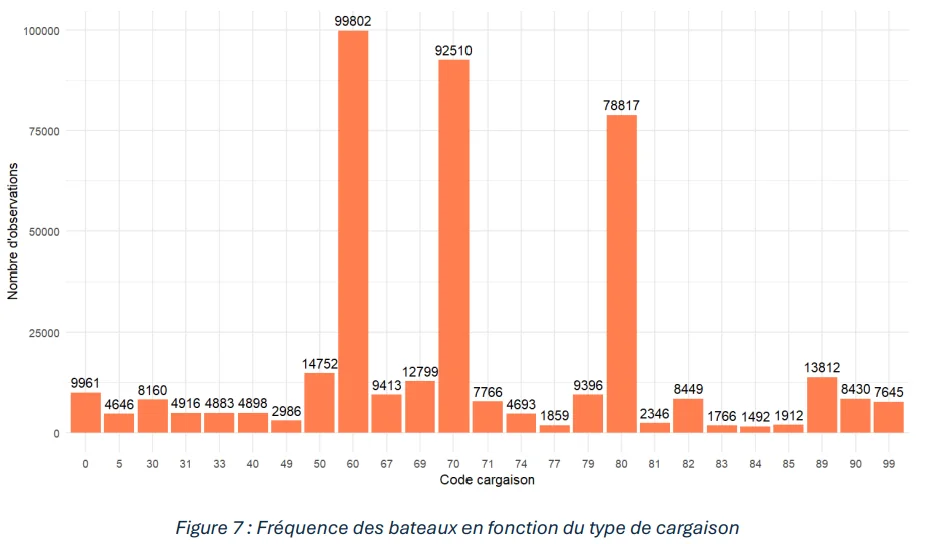
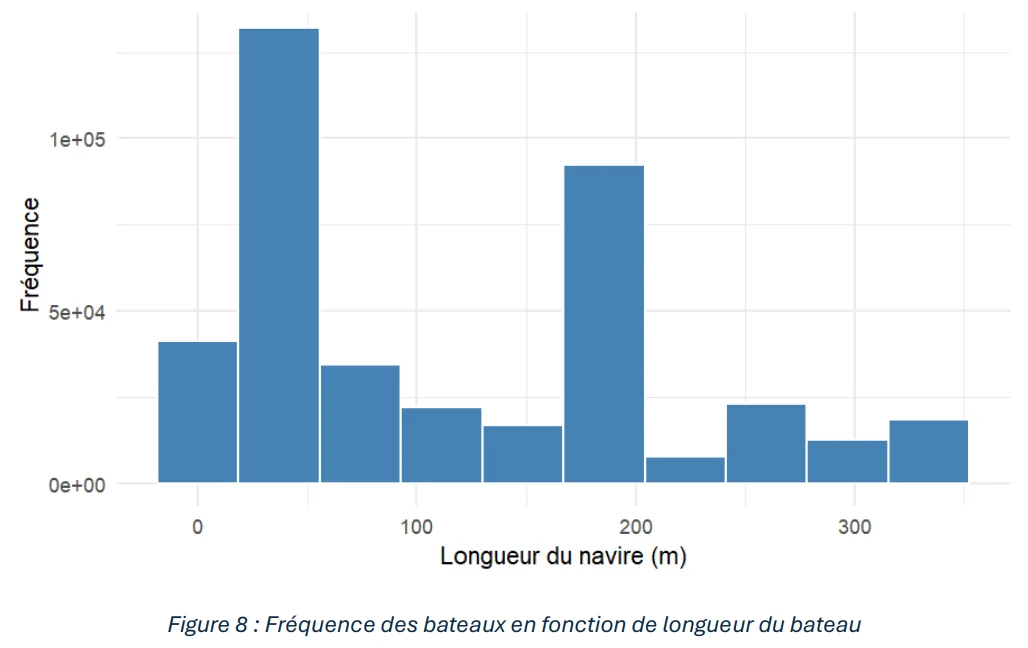
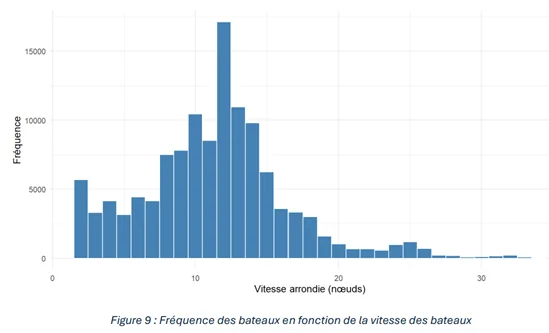
Visualisations
Des graphiques pour comprendre la répartition des navires : par type (passagers, cargos, tankers), par vitesse et par longueur.
-
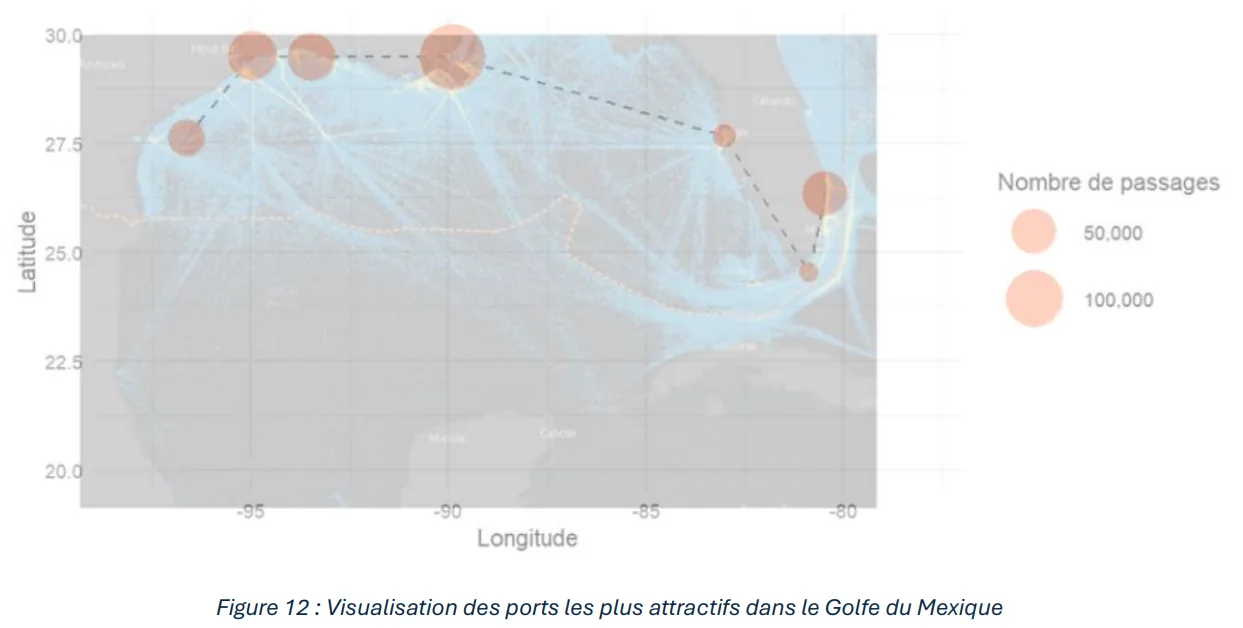
Retrouver les ports principaux
Extraction automatique des couples de positions les plus fréquents pour en déduire les points de forte densité, puis vérification sur une carte du golfe du Mexique.
-
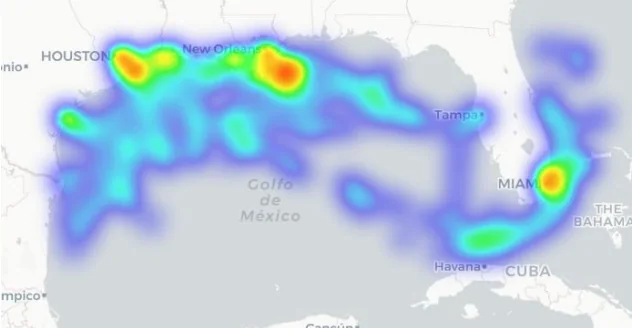
Cartes de chaleur
Génération de cartes de chaleur montrant les zones où le trafic maritime est le plus dense.
-
Analyse des corrélations
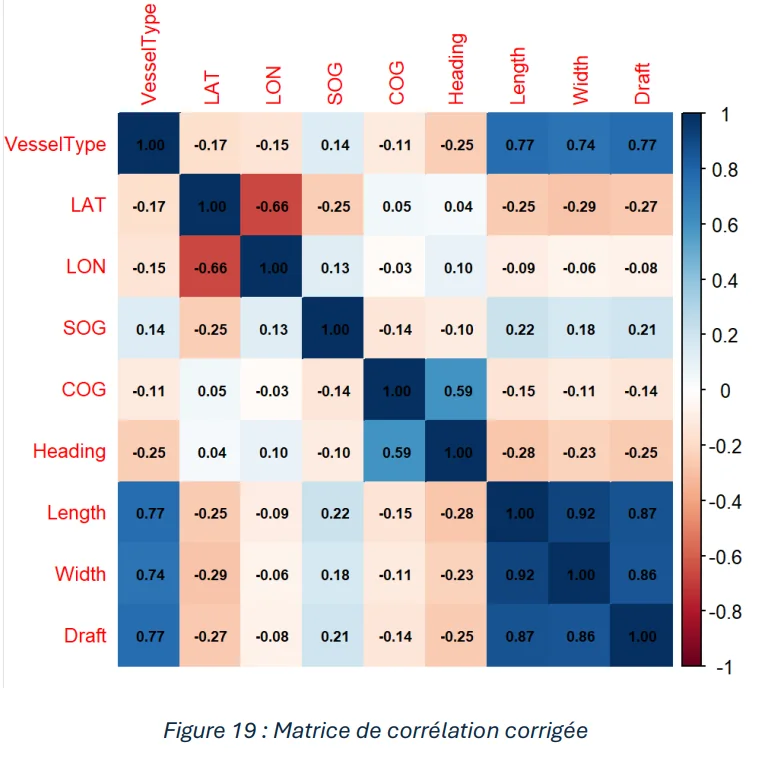
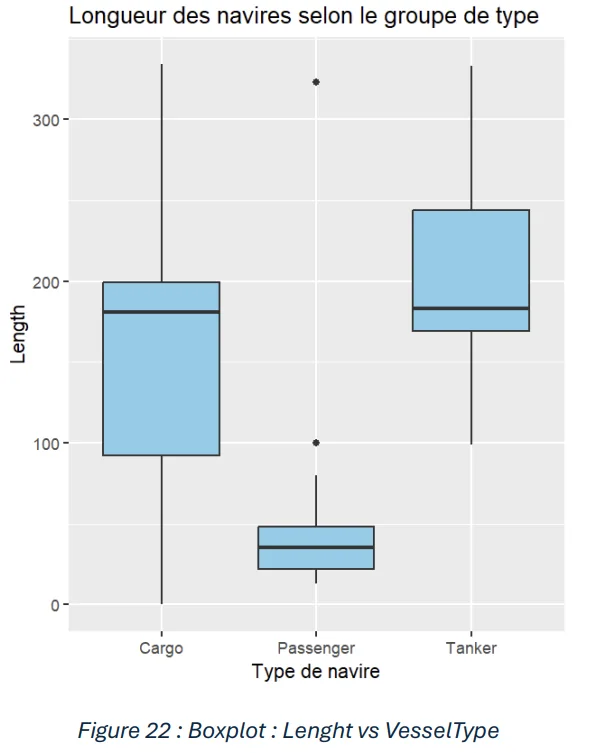
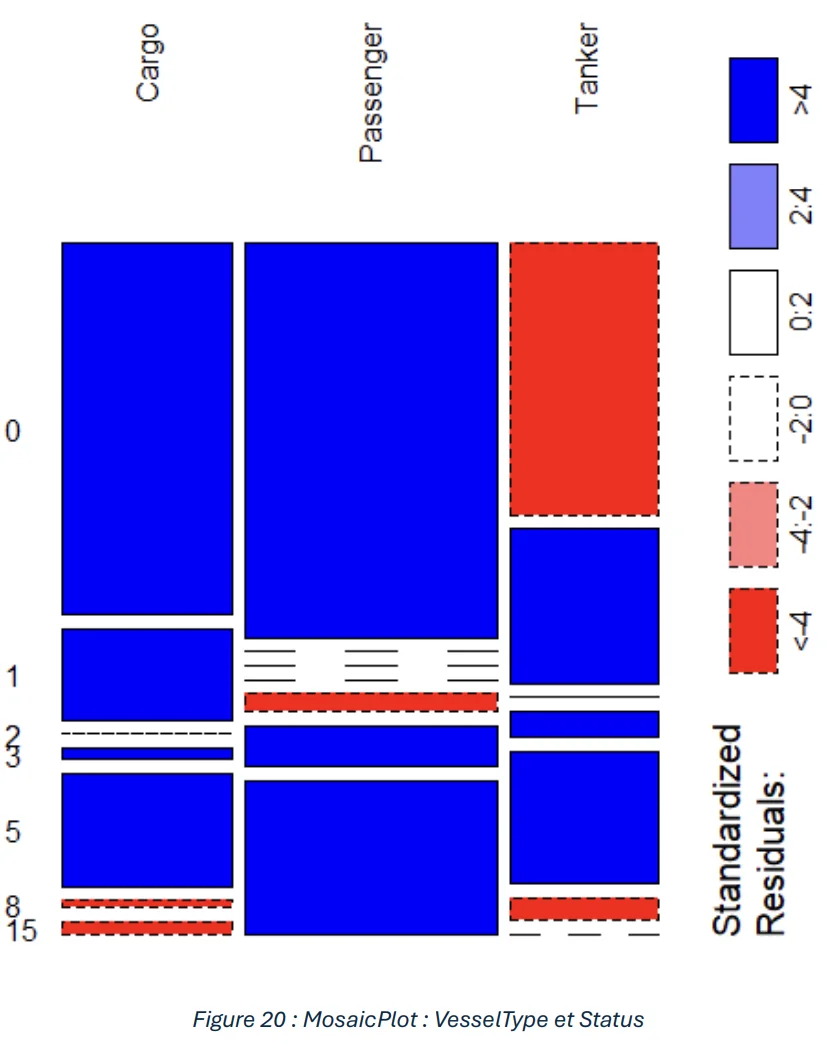
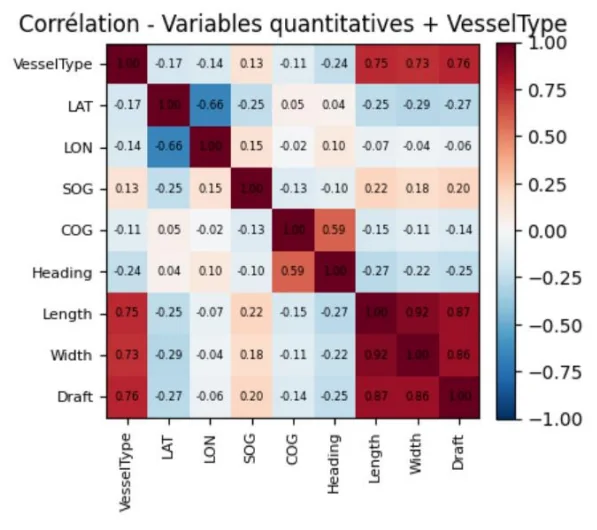
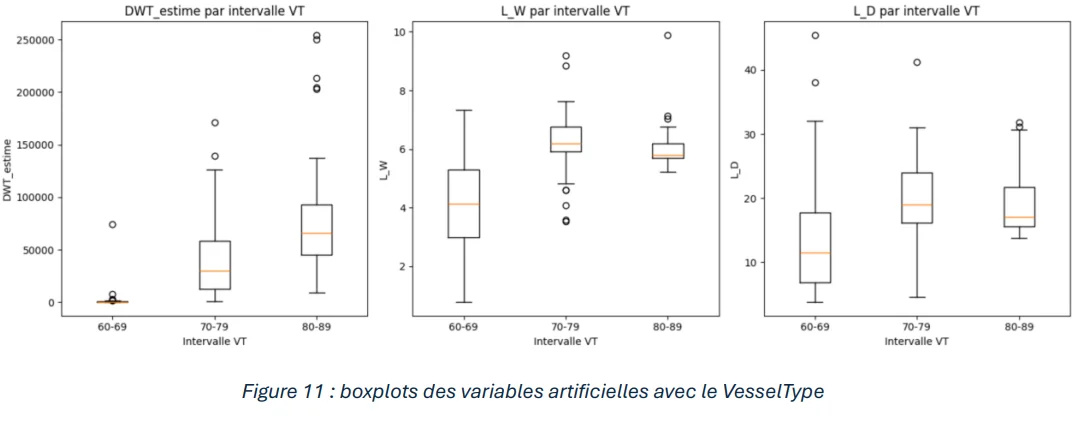
Étude des corrélations entre variables pour préparer la prédiction du type de navire : matrice de corrélation, tests statistiques (Chi², ANOVA) et boxplots pour valider les relations.
-
Diagrammes de flux
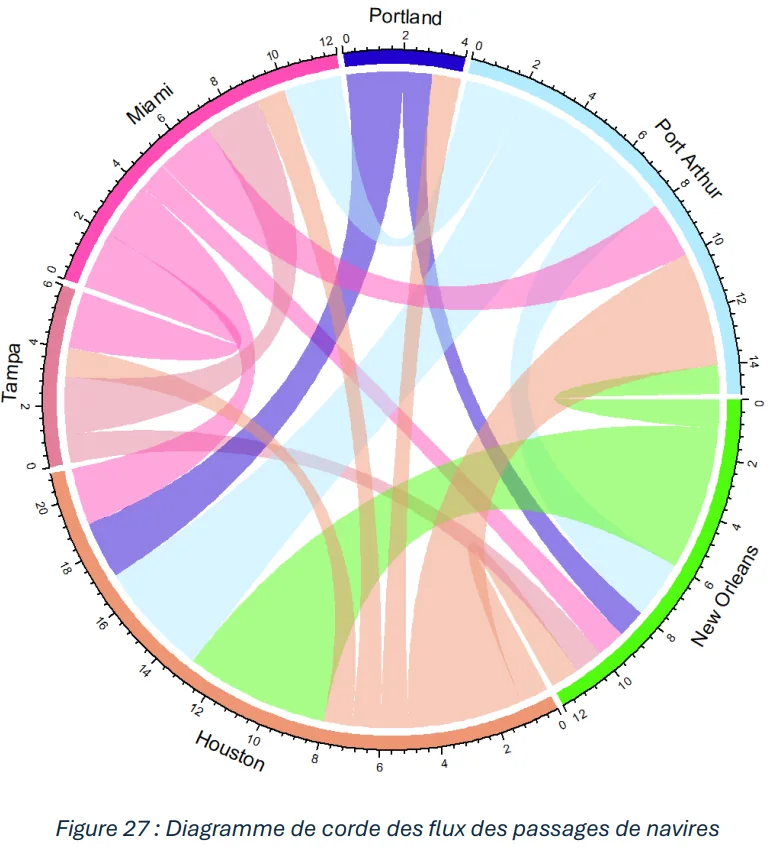
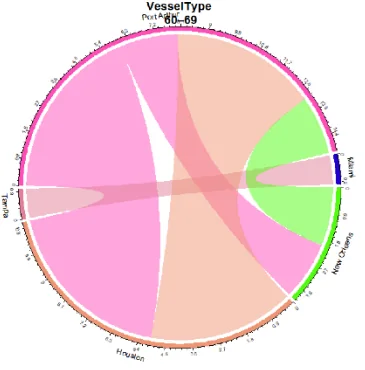
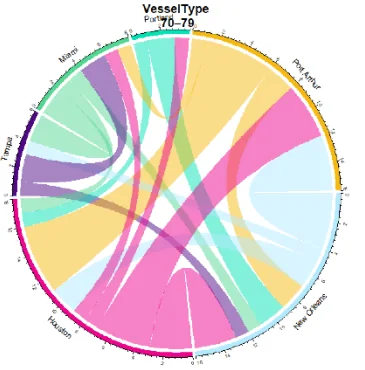
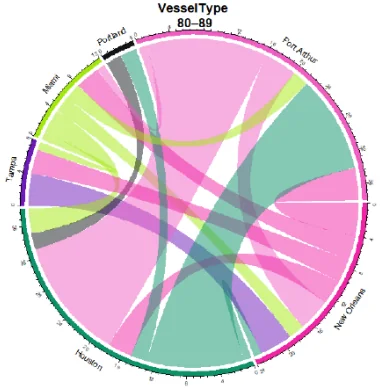
Des diagrammes de cordes visualisent les flux entre les ports majeurs, puis les échanges par type de navire, pour analyser les routes privilégiées.
Intelligence artificielle
-
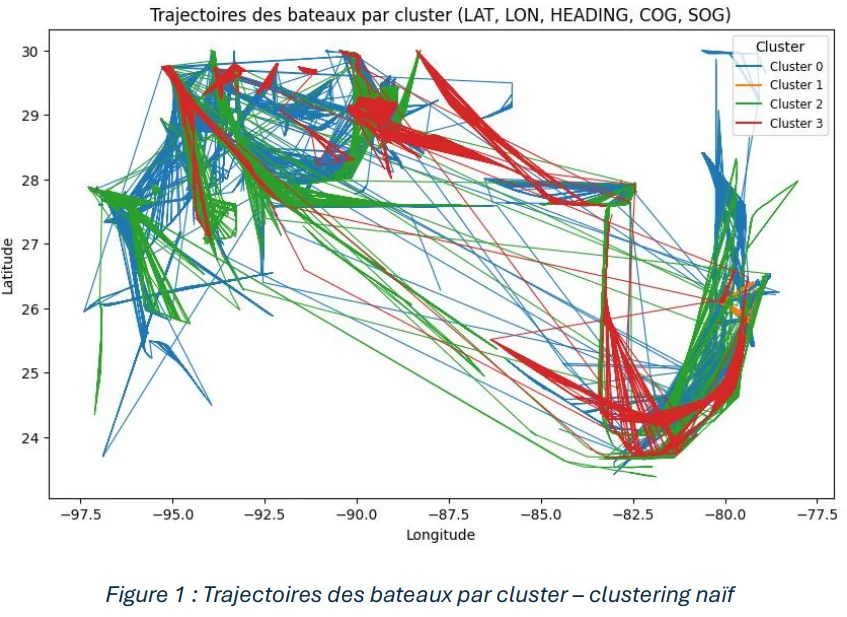
Clustering des trajectoires : première tentative
Une première approche naïve : K-means appliqué directement aux données de navigation (COG, SOG, latitude, longitude…).
-
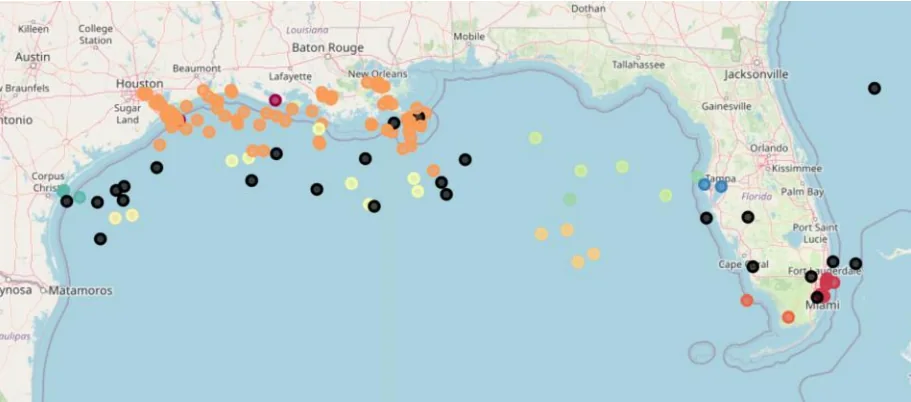
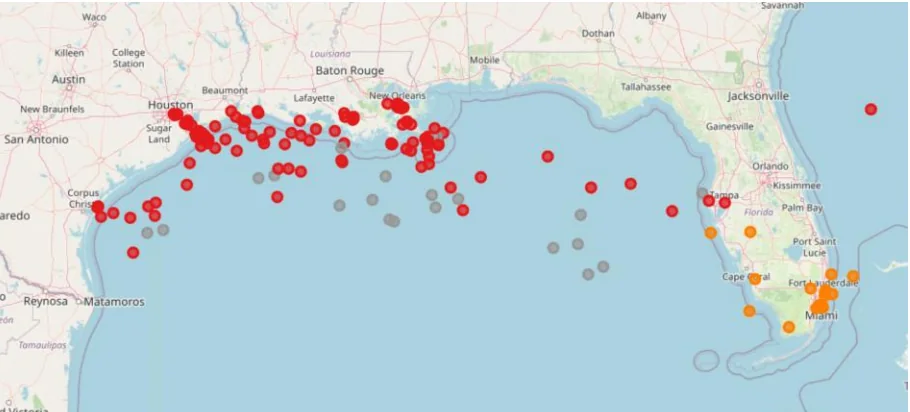
Comparaison de méthodes de clustering
Essai de plusieurs méthodes sur ces mêmes données de navigation, puis clustering par DBSCAN et par classification ascendante hiérarchique (CAH).
-
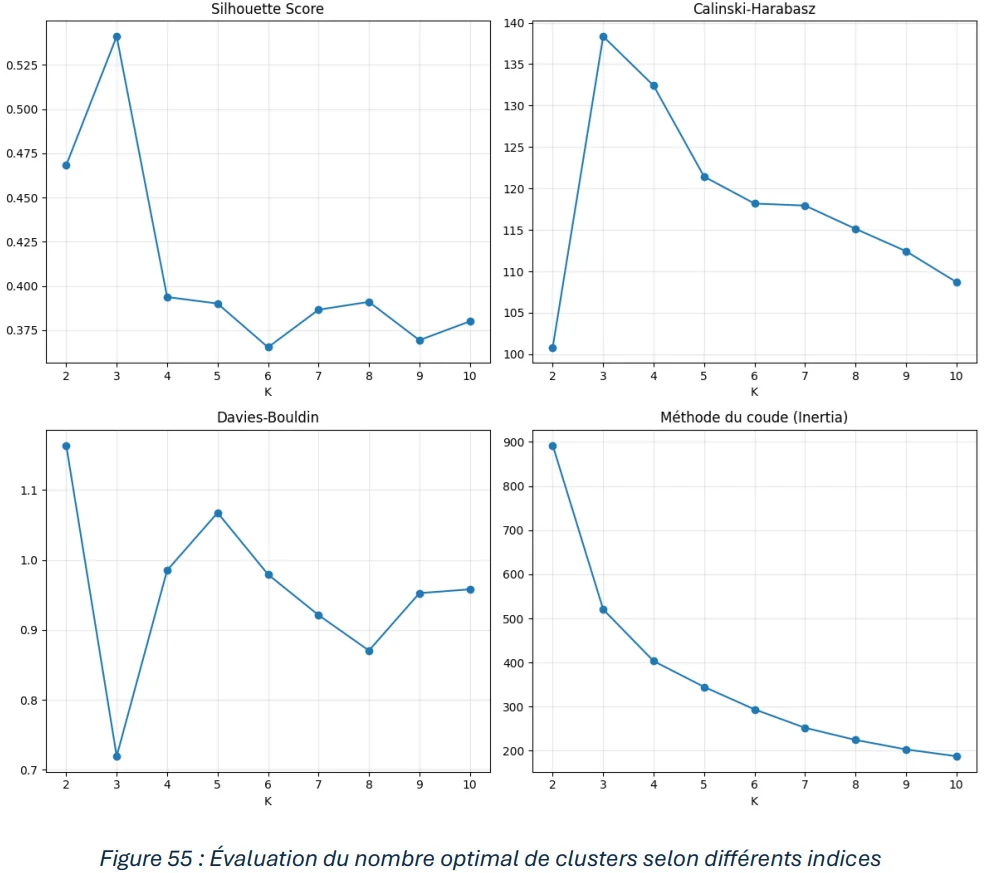
Choix du nombre de clusters
Évaluation du nombre optimal de clusters avec l'indice de silhouette, la méthode du coude, l'indice de Davies-Bouldin (à minimiser) et celui de Calinski-Harabasz (à maximiser).
-
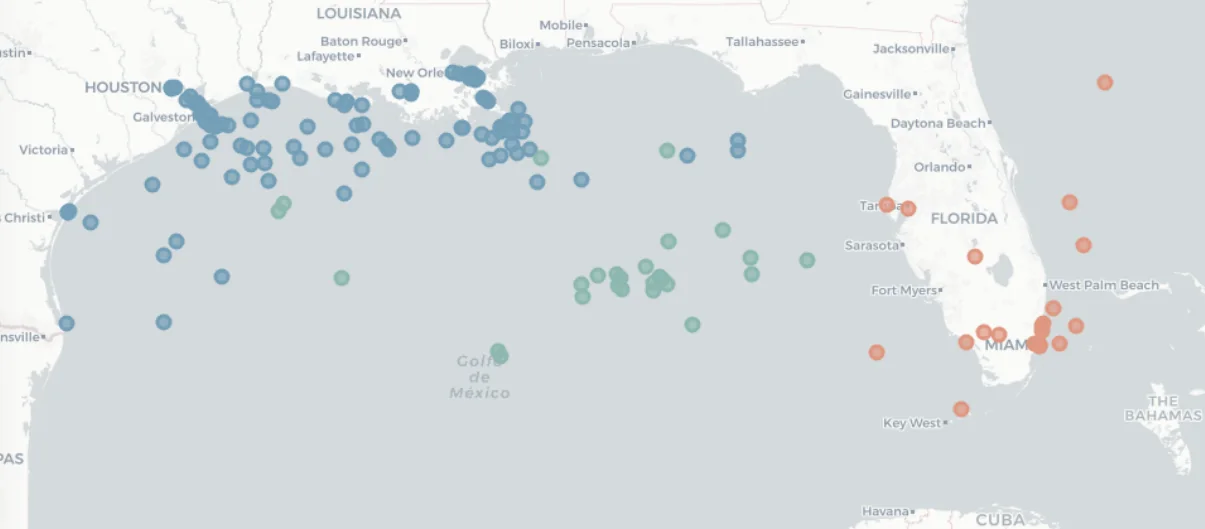
Feature engineering et visualisation des clusters
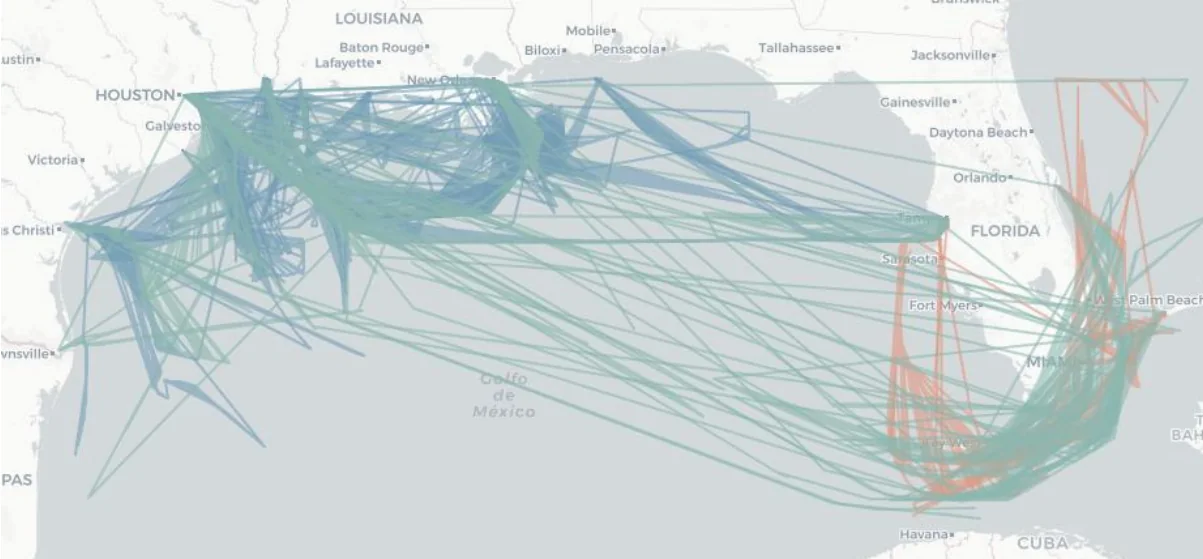
Extraction de 10 descripteurs par trajectoire : bornes géographiques, centres, étendues, surface couverte, distance totale. Après normalisation et sélection des paramètres pertinents, un K-means sur ces nouvelles variables fait apparaître des zones d'activité distinctes, cohérentes dans l'espace et selon le type de navire.
-
Prédiction du type de navire
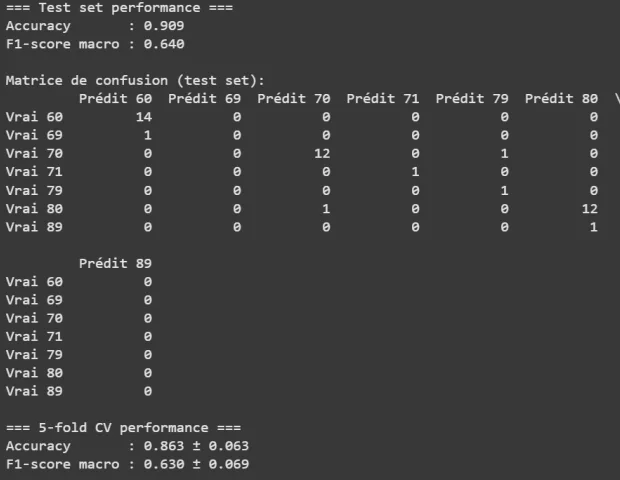
Un modèle de classification prédit le type de navire ; il est évalué par matrice de confusion et validation croisée. Une variable supplémentaire, la contenance estimée du navire calculée avec une formule d'architecture navale, est justifiée par la matrice de corrélation et les boxplots.
-
Prédiction de trajectoires
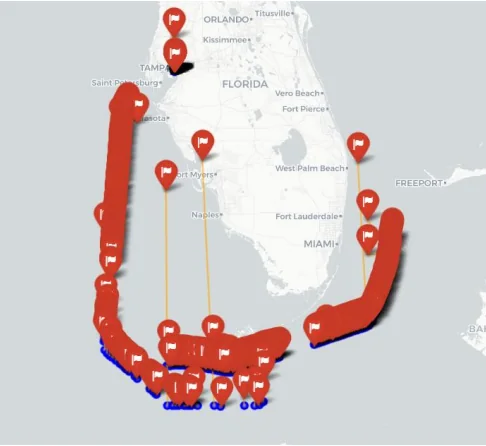
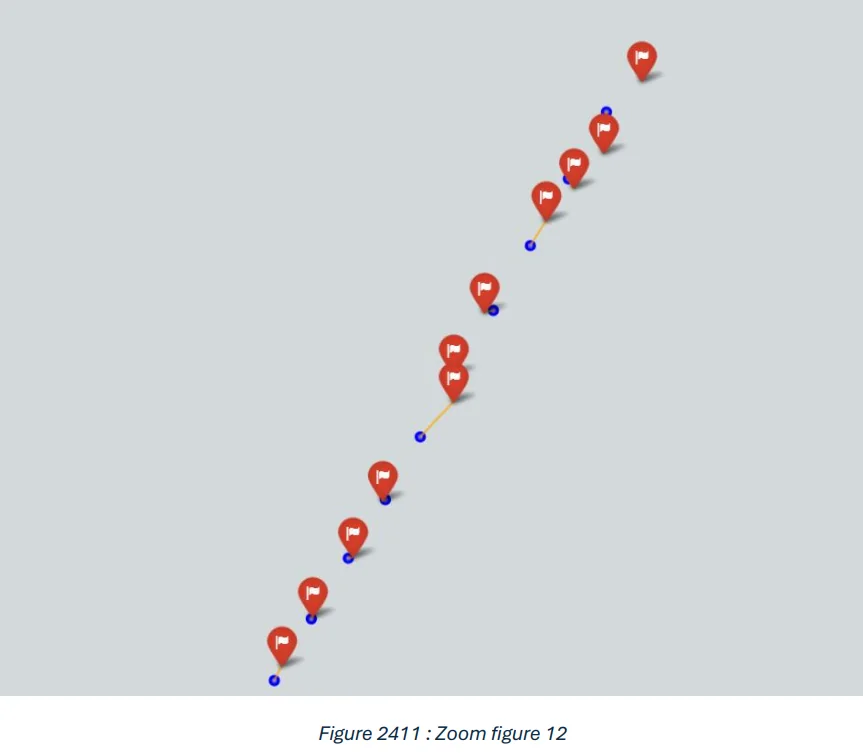
Un MultiOutputRegressor prédit la latitude et la longitude à 5, 10 et 15 minutes. Les positions prédites (drapeaux rouges) suivent de très près les positions réelles (points bleus).
-
Validation sur la base AIS réelle
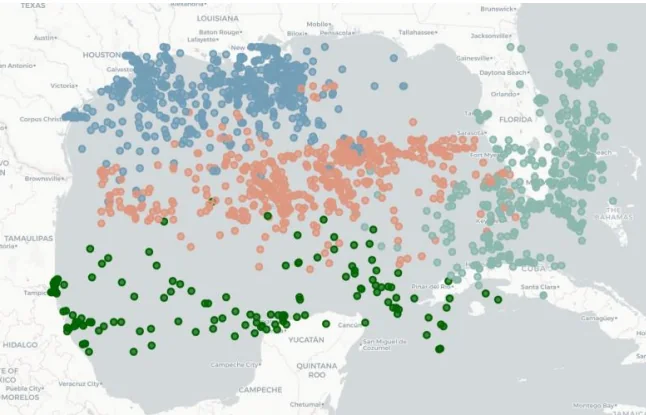
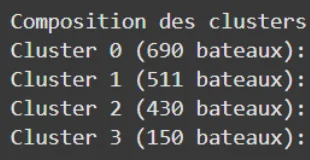
Toute la démarche a ensuite été rejouée sur les véritables données de trafic maritime. Seule la nouvelle clusterisation est présentée ici.
Développement web
-
Architecture de l'application
Une application web complète (HTML, CSS, JavaScript, PHP, scripts Python, SQL) pour explorer de façon interactive les résultats de l'analyse.
-
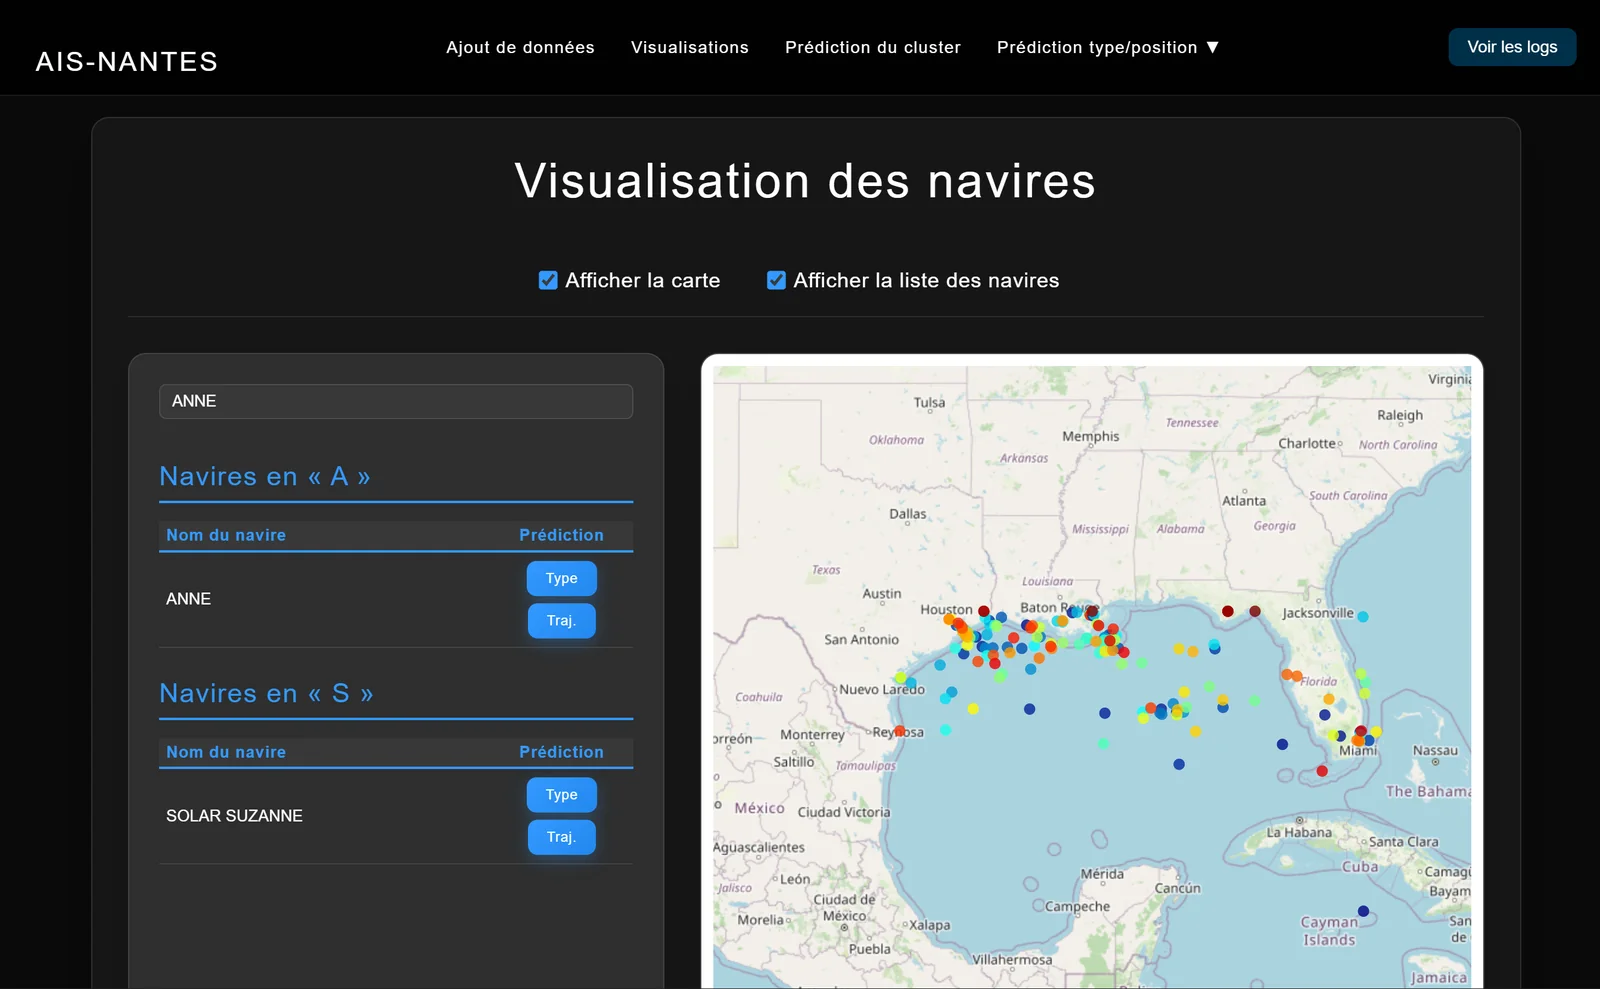
Visualisation des navires
Recherche et visualisation des navires avec un double affichage, liste détaillée et carte interactive. Des boutons permettent de prédire le type et la trajectoire du navire sélectionné.
-
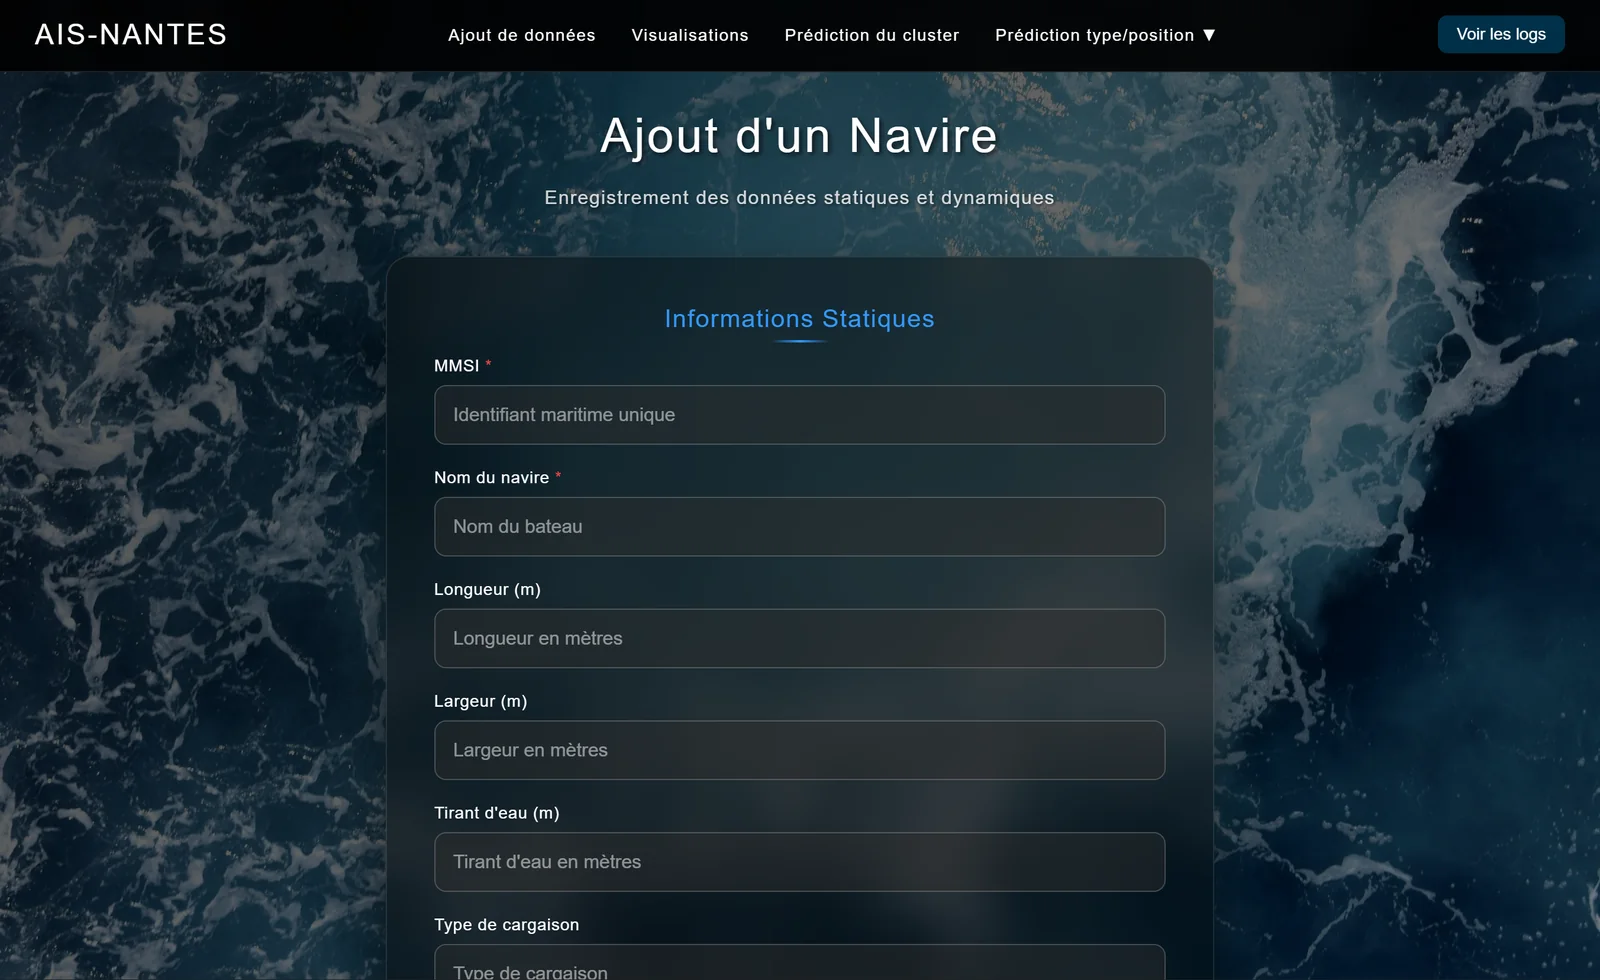
Formulaire d'ajout de navire
Un formulaire détaillé pour enregistrer de nouveaux navires, avec leurs informations statiques (MMSI, nom, dimensions) et dynamiques (position, vitesse, cap). Les données sont validées en temps réel et enregistrées dans une base SQL.
-
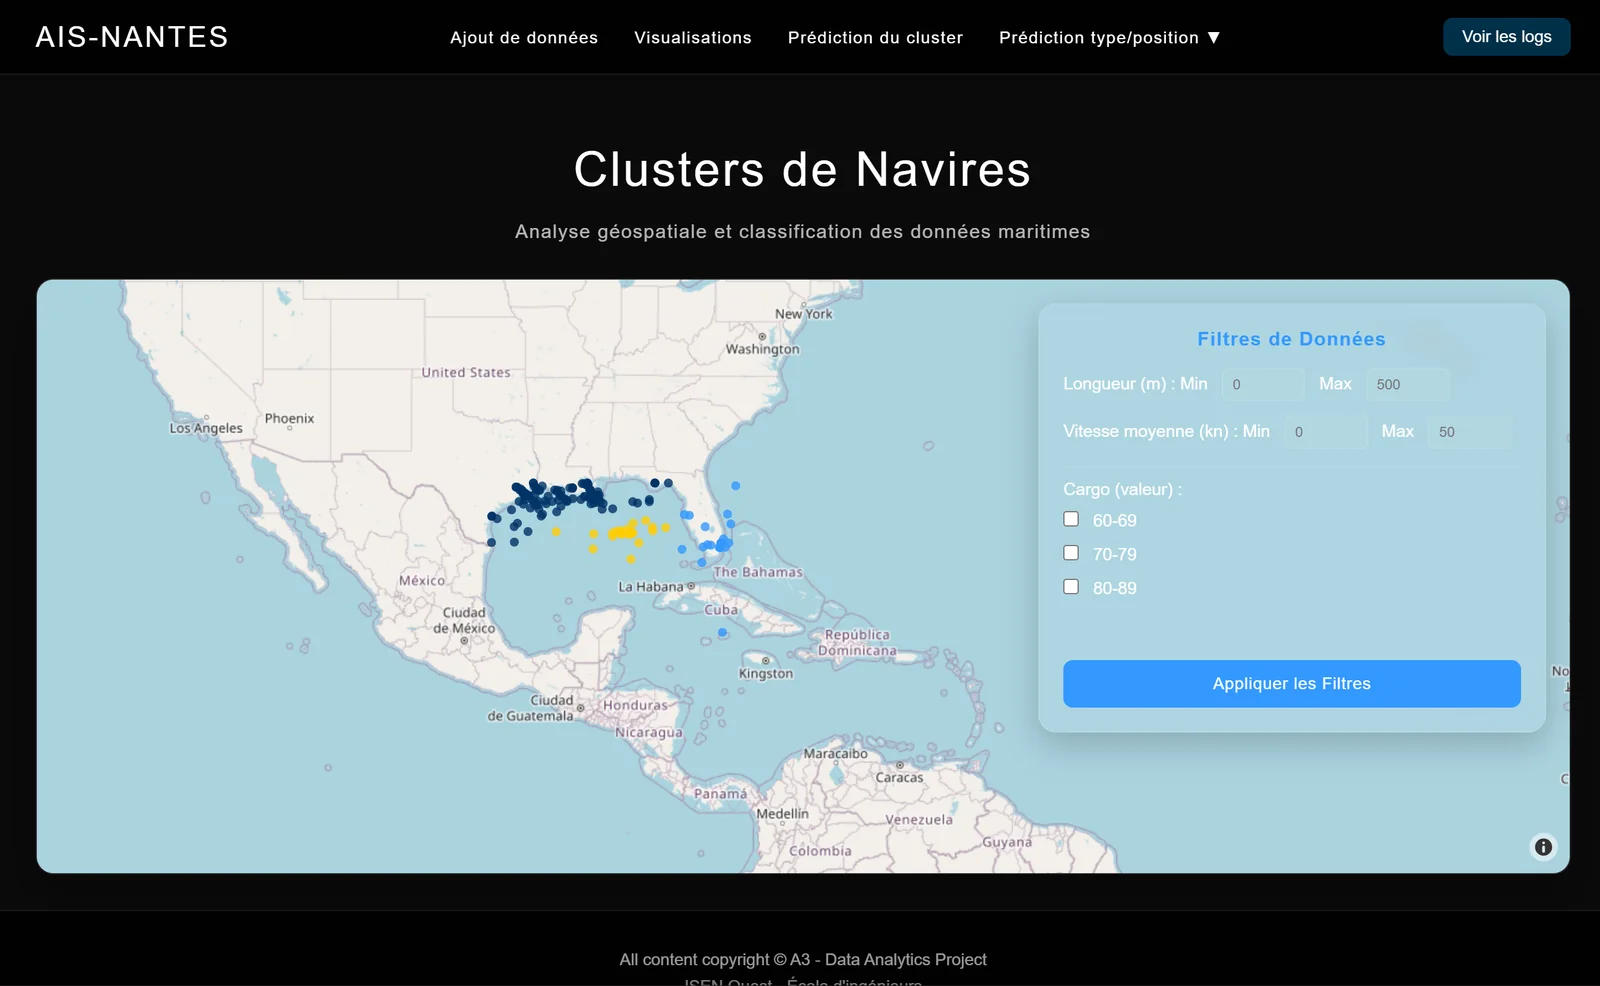
Clustering géospatial interactif
Calcul et affichage des clusters de navires sur une carte interactive, avec des filtres dynamiques (longueur, vitesse moyenne, type de cargaison) pour repérer les zones d'activité et les schémas de navigation.
-
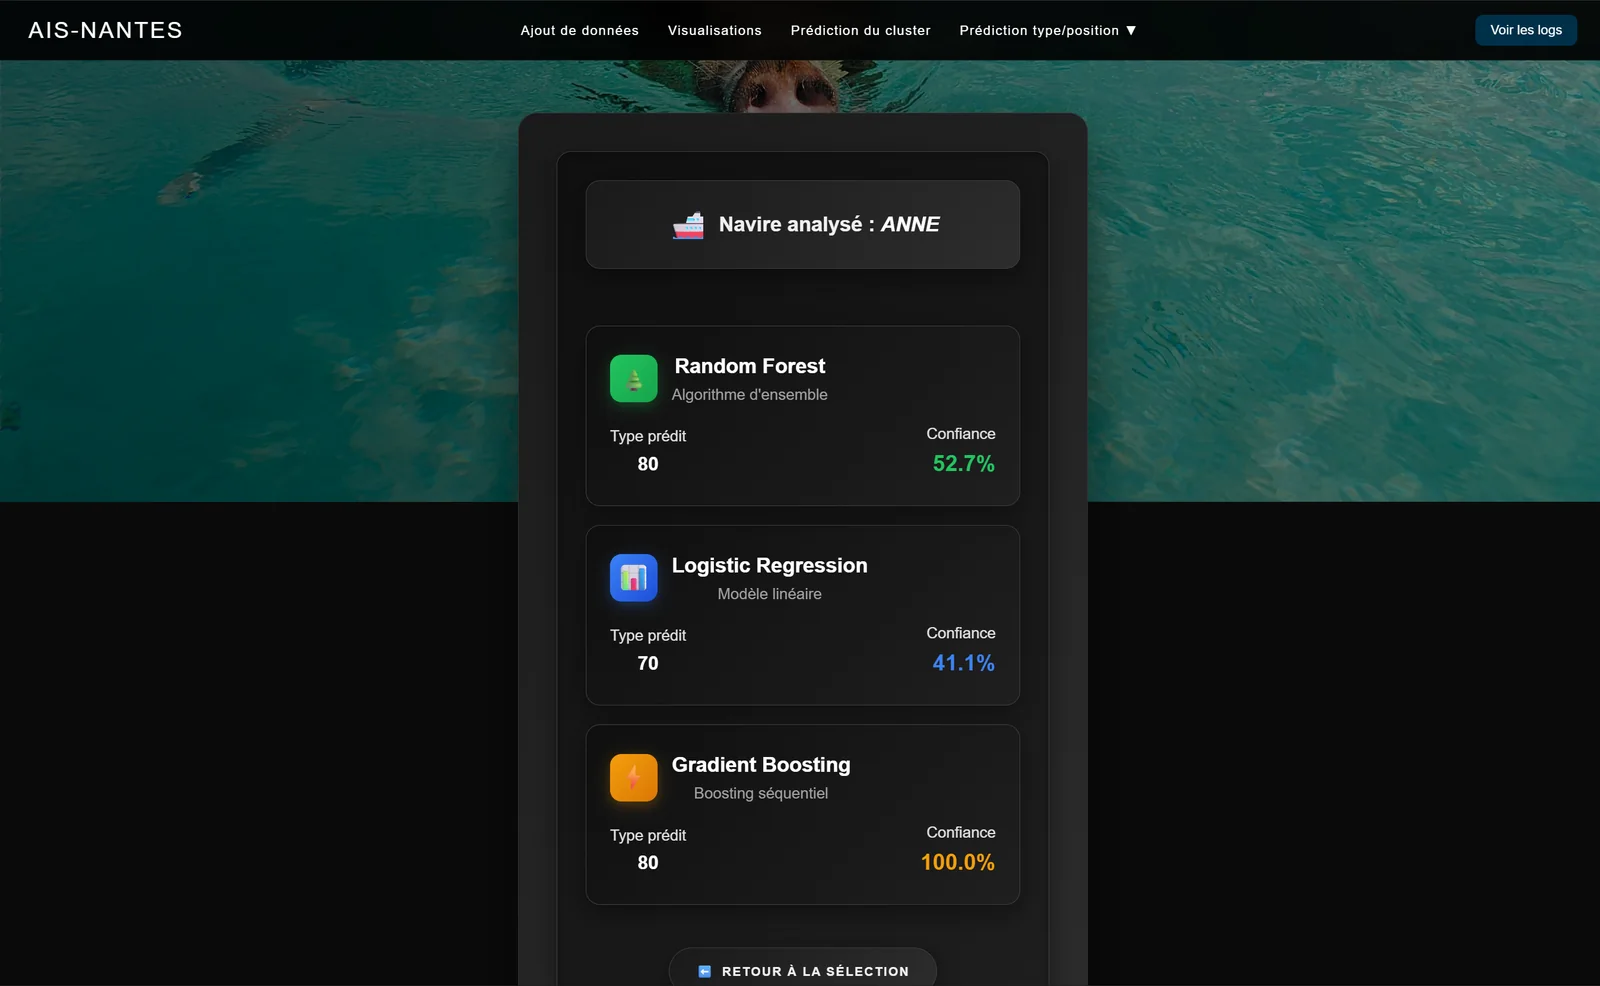
Prédiction du type de navire
Trois modèles (Random Forest, régression logistique, Gradient Boosting) classent automatiquement le navire ; le score de confiance de chacun est affiché pour comparaison.
-
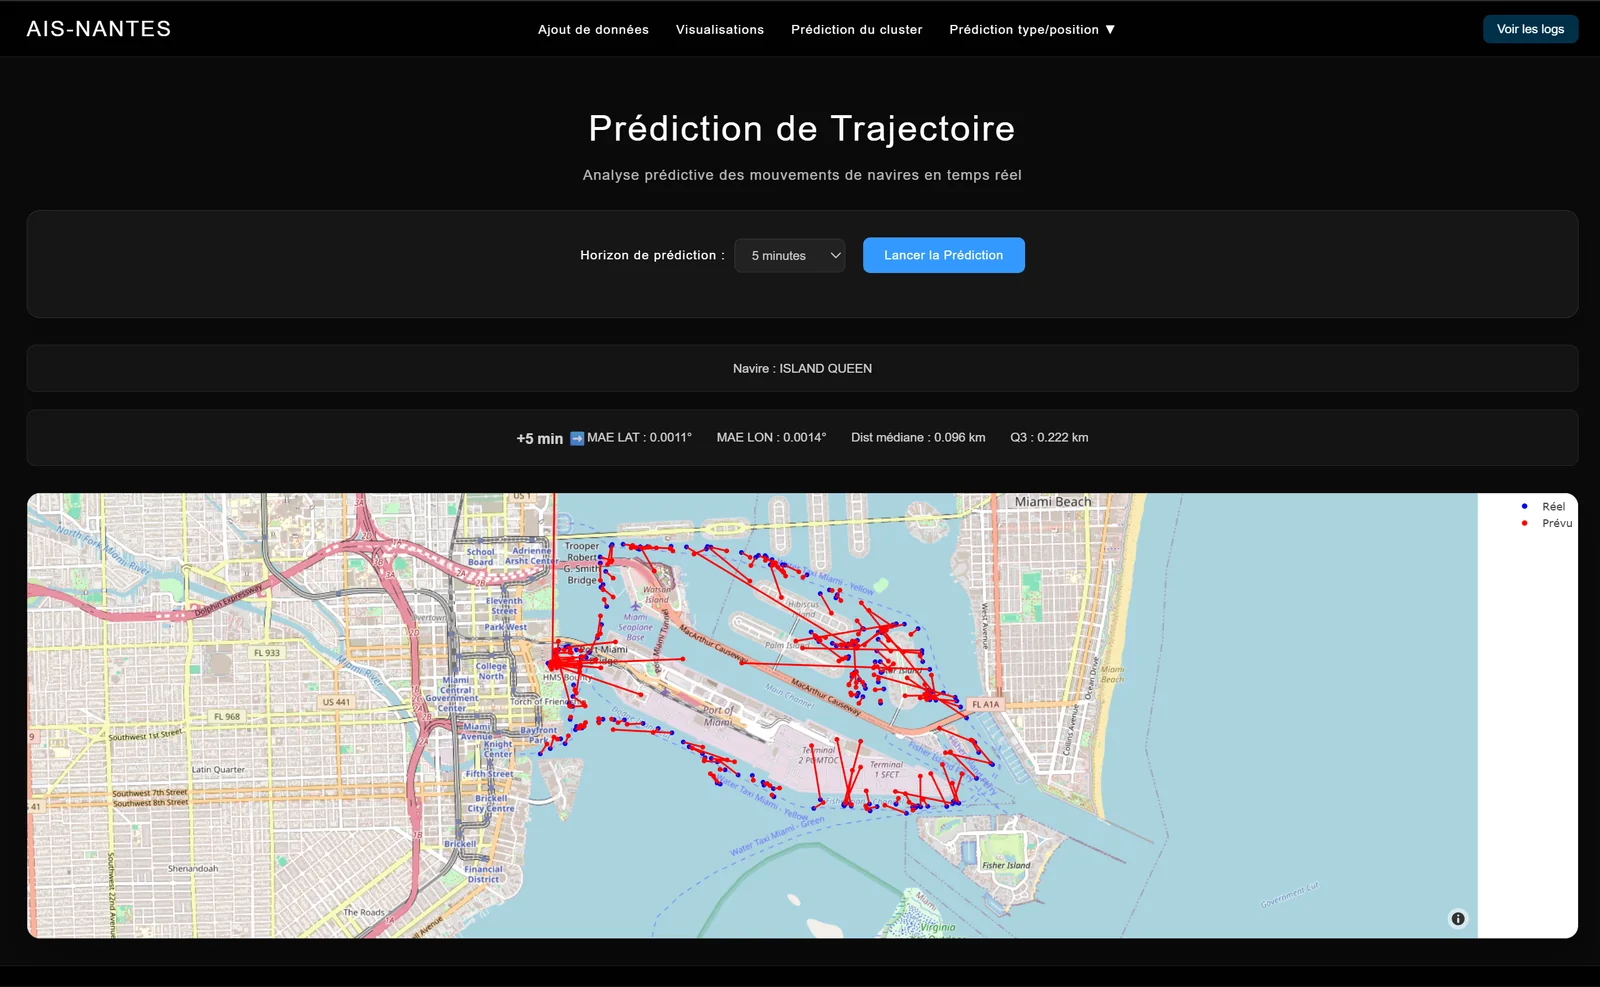
Prédiction de trajectoires
Prédiction de la trajectoire d'un navire avec choix de l'horizon (5, 10 ou 15 minutes). Sur la carte, les points bleus sont les positions réelles et les points rouges les positions prédites.
-
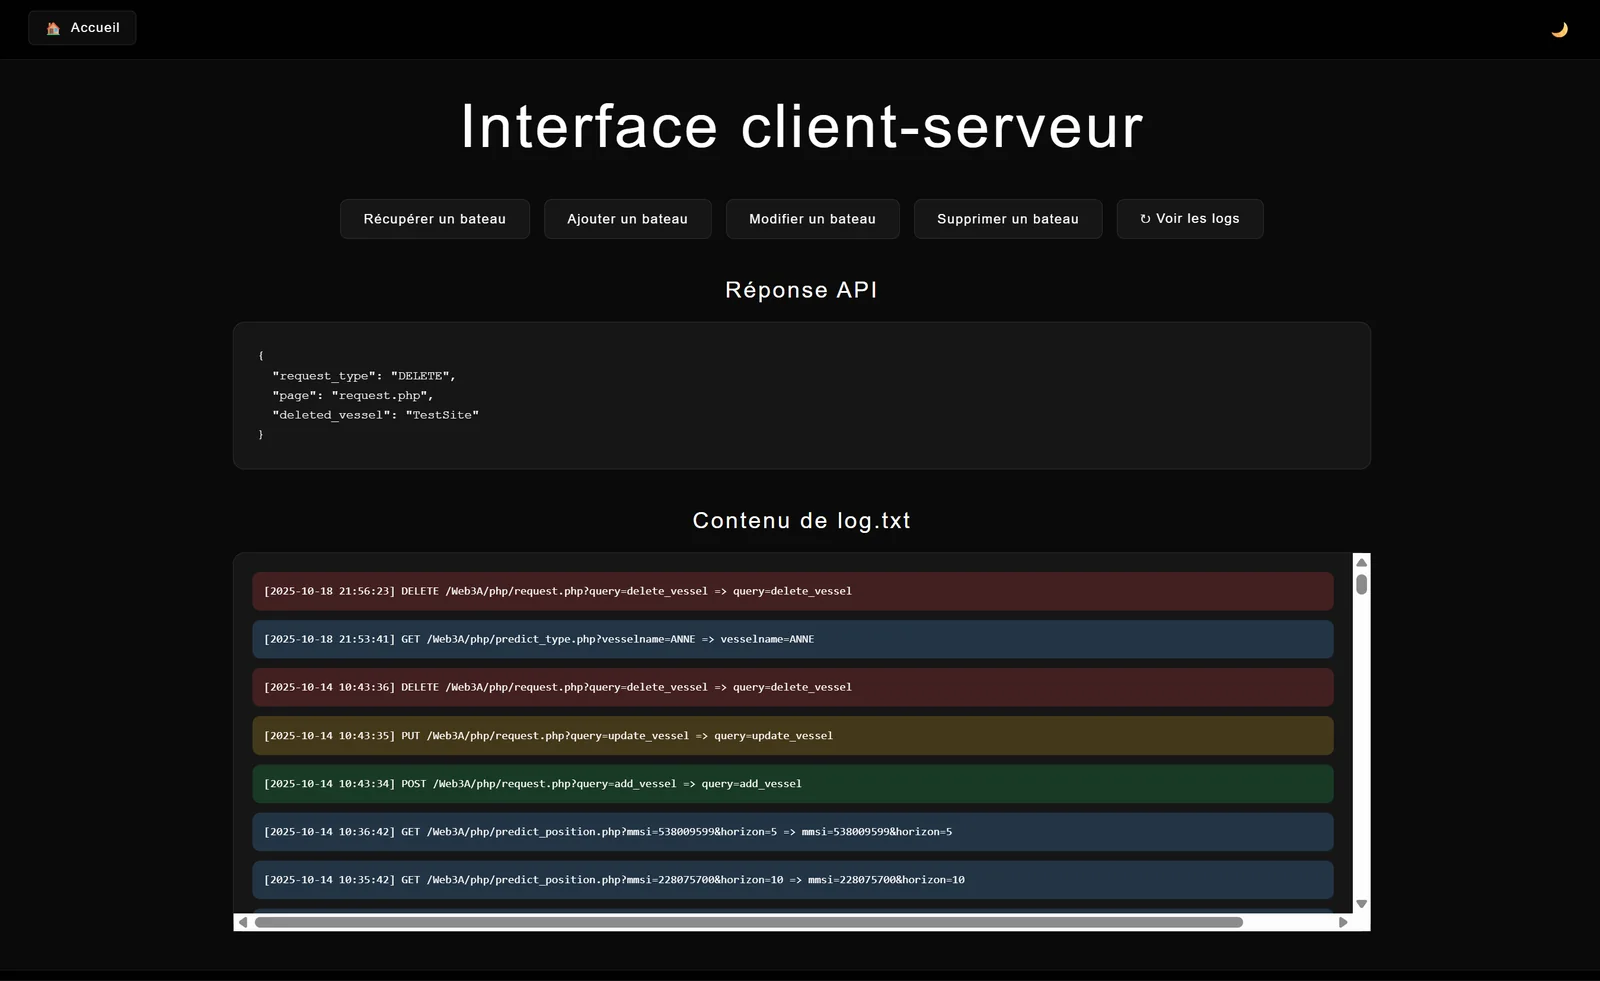
Interface client-serveur
Des boutons testent les requêtes CRUD (création, lecture, modification, suppression) de l'API REST, et un journal affiche en temps réel chaque opération effectuée sur la base de données.
Documents
Les rapports et les supports de présentation complets du projet.